Software · Jun 6, 2024 · 10 dk okuma
Database Index Nedir ve Neden Bazen Performansı Daha Kötü Hale Getirir?
Database index, sorgunun aradığı satırlara ulaşmasını hızlandırabilir. Ancak yanlış index, gereksiz I/O, yüksek write maliyeti ve kötü execution plan nedeniyle sistemi yavaşlatabilir. Belirleyici olan index sayısı değil, erişim maliyetidir.
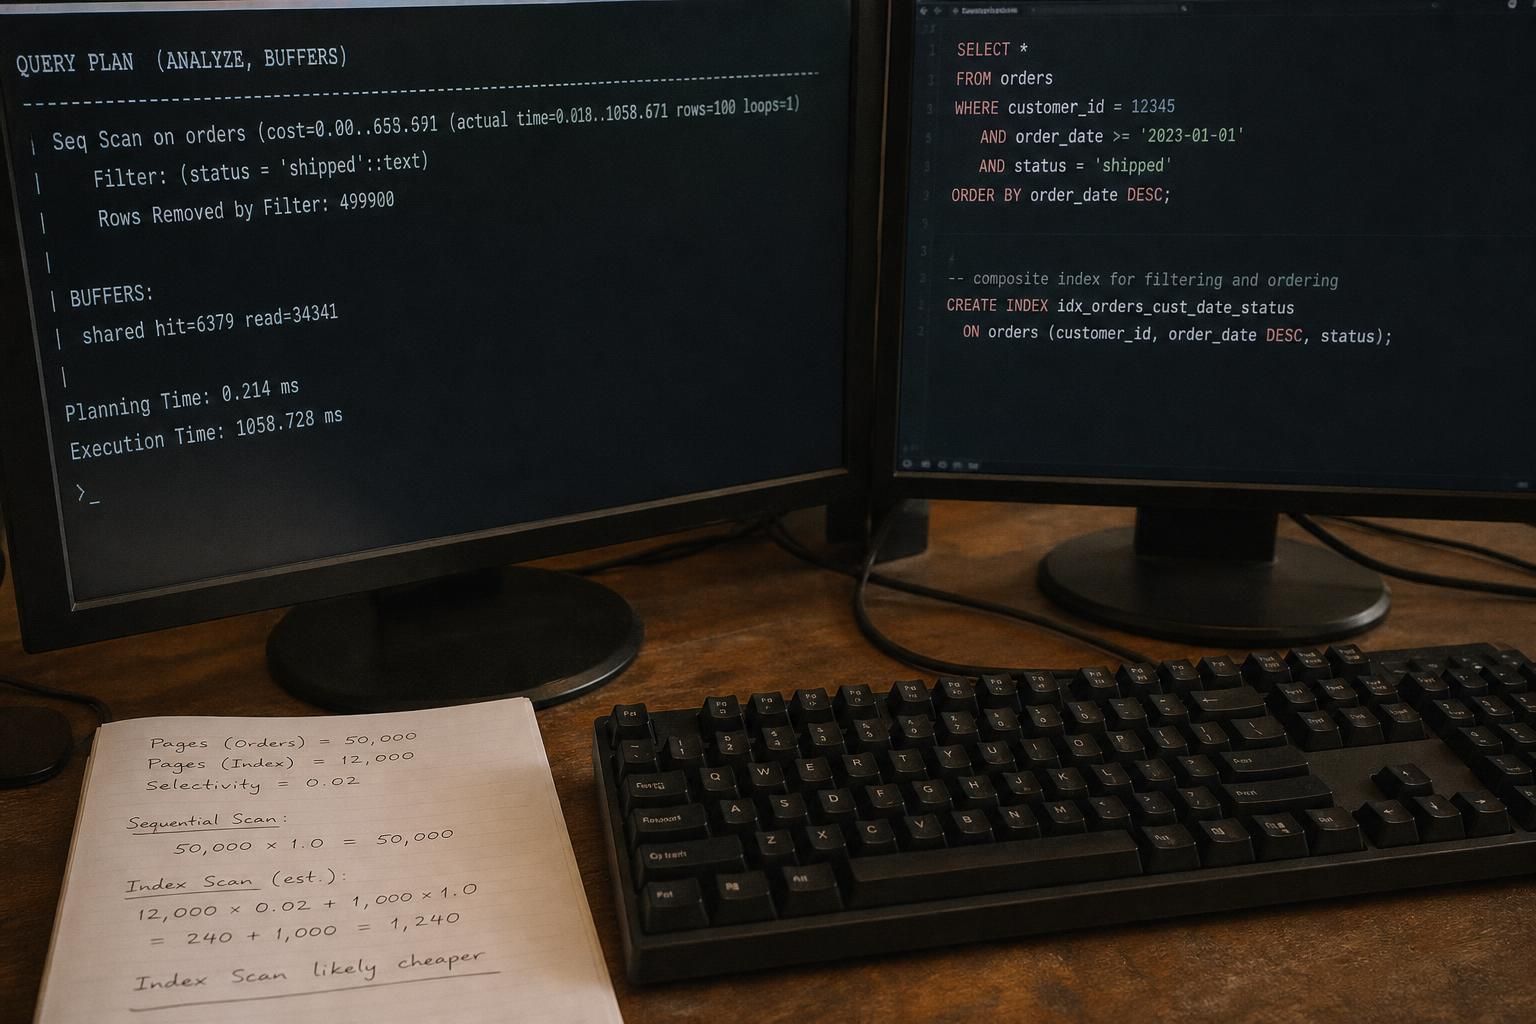
Database index, bir sorgunun ihtiyaç duyduğu satırlara ulaşırken okuması gereken veri miktarını azaltmak için kullanılan ek bir veri yapısıdır. Ancak index kullanmak her zaman daha hızlı sorgu çalıştırmak anlamına gelmez. Bir index, arama maliyetini düşürürken ek veri erişimleri oluşturabilir, her write işlemine bakım yükü ekleyebilir ve query optimizer tarafından seçildiğinde index bulunmayan bir plana göre daha yavaş sonuç üretebilir. Performansı belirleyen şey index varlığı değil, sorgunun toplam erişim maliyetidir.
Bu ayrım özellikle veri büyüdüğünde önem kazanır. Küçük bir tabloda fark edilmeyen index maliyeti, milyonlarca satır içeren bir tabloda disk erişimi, memory kullanımı ve transaction süresi olarak ortaya çıkar. Üstelik sorun her zaman yavaş bir SELECT değildir. Okuma sorgusunu hızlandırmak için eklenen index, yoğun INSERT ve UPDATE yapan bir sistemin throughput değerini düşürebilir. Doğru karar, index eklemeden önce database engine'in hangi veriyi hangi sırayla okuyacağını anlamayı gerektirir.
Index, veriyi değil erişim yolunu düzenler
Bir database tablosunu fiziksel olarak depolanan satırlar olarak düşünelim. orders tablosunda id, customer_id, status, created_at ve total_amount kolonları bulunsun. customer_id = 42 koşuluyla siparişleri aradığımızda database, uygun bir erişim yapısı yoksa tablodaki satırları taramak zorunda kalabilir. Bu işlem PostgreSQL'de genellikle Seq Scan, SQL Server'da depolama yapısına bağlı olarak Table Scan veya Clustered Index Scan şeklinde görünür.
customer_id üzerinde bir B-Tree index bulunduğunda farklı bir yol açılır. Database önce index içinde 42 değerini arar, ardından ilgili satırların konumlarını bulur. Buradaki kazanç, aramayla ilgisiz satırların büyük bölümünü okumamaktır. Fakat index araması da ücretsiz değildir: index sayfaları okunur, gerekirse heap veya clustered data sayfalarına gidilir ve sonuçlar sorgunun istediği biçimde hazırlanır.
B-Tree, sıralı anahtarları dengeli bir ağaç yapısında tutar. Modern relational database sistemlerinde kullanılan klasik B-Tree index yapıları çoğunlukla B+Tree özellikleri taşır: üst seviyelerde yönlendirme anahtarları, leaf seviyesinde ise aranabilir index entry'leri bulunur. Leaf entry'nin tam içeriği database engine'e ve index türüne bağlıdır.
Örneğin customer_id değerini arayan engine, root page üzerinden uygun child page'e ilerler. Ara seviyeleri geçtikten sonra leaf page'e ulaşır. Ağaç dengeli kaldığı için bir taraftaki aramalar diğer tarafa göre kontrolsüz biçimde uzamaz. Bir page çok sayıda anahtar taşıyabildiğinden, büyük tablolarda bile arama birkaç ağaç seviyesiyle tamamlanabilir.
Bu davranış çoğunlukla O(log n) arama karmaşıklığıyla anlatılır. Ancak gerçek sorgu maliyetini yalnızca bu ifade açıklamaz. Index içinde bir anahtarı bulmak ile o anahtara karşılık gelen yüz binlerce satırı okumak aynı işlem değildir. İlk aşama hızlı olsa bile ikinci aşama pahalı olabilir.
B-Tree'nin bir başka avantajı sıralamadır. (customer_id, created_at) üzerinde tanımlanmış bir index, aynı müşteriye ait kayıtları created_at sırasıyla erişilebilir hale getirebilir. Bu sayede uygun bir sorgu hem filtreleme yapabilir hem de ayrı bir sort işleminden kaçınabilir. Buna karşılık B-Tree her arama türü için uygun değildir. Örneğin başında wildcard bulunan LIKE '%phone' koşulu, standart B-Tree'nin sıralı başlangıç arama avantajını genellikle kullanamaz.
Daha fazla index her zaman daha az iş demek değildir
Index hakkında en yaygın açıklama, onu kitabın sonundaki alfabetik dizine benzetmektir. Benzetme arama mantığını anlatır fakat kritik bir maliyeti gizler: index, verinin kendisi olmayabilir. Dizinden doğru sayfayı bulduktan sonra o sayfaya gitmek gerekir. Database dünyasında bu ikinci erişim, özellikle çok sayıda satır döndüren sorgularda belirleyicidir.
Burada clustered ve non-clustered index ayrımı devreye girer. SQL Server'da clustered index, tablonun veri satırlarını clustered key düzenindeki leaf seviyesinde saklar. Non-clustered index ise ayrı bir B-Tree yapısıdır; leaf entry'leri index key değerlerini ve temel satıra ulaşmak için gereken row locator bilgisini taşır. Clustered table üzerinde bu locator genellikle clustered key'dir.
PostgreSQL'in standart B-Tree index yapısı farklı çalışır. Index entry'leri heap tuple konumlarını gösterir ve tablo satırları ayrı heap sayfalarında bulunur. PostgreSQL'deki CLUSTER komutu tabloyu bir index'e göre fiziksel olarak yeniden düzenleyebilir, ancak SQL Server'daki gibi sürekli korunan bir clustered index oluşturmaz. Dolayısıyla aynı terimi bütün database engine'lere aynı fiziksel anlamda uygulamak hatalıdır.
Non-clustered index üzerinden bulunan satırın ihtiyaç duyulan kolonları index içinde bulunmuyorsa engine temel tabloya geri döner. SQL Server'da bu işlem plana göre Key Lookup veya RID Lookup olarak görülebilir. PostgreSQL'de benzer ek veri erişimleri Index Scan sırasında heap fetch olarak gerçekleşebilir.
Az sayıda satır için bu maliyet makuldür. Ancak binlerce farklı data page'e dağılmış kayıtları okumak gerektiğinde index araması çok sayıda düzensiz erişim üretebilir. Buna karşılık sequential scan, daha fazla satıra bakmasına rağmen sayfaları daha düzenli okuyabilir. Özellikle storage erişimi ve cache davranışı açısından sequential scan bazen daha ucuzdur.
Bu nedenle SELECT * FROM orders WHERE status = 'completed' sorgusunda status index'inin bulunması, index'in kullanılmasını zorunlu kılmaz. Satırların büyük bölümü completed durumundaysa optimizer tabloyu taramayı tercih edebilir. Bu tercih çoğu zaman eksik optimizasyon değil, doğru maliyet hesabıdır.
Index'in performansı kötüleştirdiği durumlardan biri de optimizer'ın yanlış maliyet tahminidir. Güncel olmayan statistics, kolonlar arasındaki correlation veya değişken veri dağılımı nedeniyle engine az satır beklerken çok satır bulabilir. Sonuç, binlerce beklenmedik lookup içeren kötü bir execution plan olabilir.
Composite index, selectivity ve covering birlikte değerlendirilir
Index tasarımında en önemli özelliklerden biri selectivity'dir. Selectivity, bir koşulun satırları ne kadar daralttığını ifade eder. Örneğin bir milyon satırlık tabloda customer_id = 42 koşulu yalnızca 20 satır döndürüyorsa oldukça seçicidir. Aynı tabloda status = 'completed' koşulu 800 bin satır döndürüyorsa seçiciliği düşüktür.
Ancak selectivity tek başına index sırasını belirlemez. Sorgudaki equality koşulları, range koşulları, sıralama gereksinimi ve database engine'in erişim yöntemi birlikte değerlendirilmelidir. Özellikle composite index tasarımında bu ayrım kritiktir.
Composite index, birden fazla kolonun aynı index key içinde tutulmasıdır. Örneğin şu index'i düşünelim:
CREATE INDEX idx_orders_customer_created
ON orders (customer_id, created_at);
Bu index önce customer_id, ardından aynı müşteri içindeki created_at değerlerine göre sıralanır. Dolayısıyla şu sorguya uygun bir erişim yolu sunar:
SELECT id, created_at, total_amount
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
Engine müşteri aralığına ulaştıktan sonra uygun yönde ilerleyerek son 20 kaydı bulabilir. B-Tree'nin ters yönde taranabilmesi sayesinde birçok engine bu işlem için ayrıca descending index gerektirmez. Ancak sorgunun gerektirdiği kolonların tamamı index'te bulunmuyorsa temel tabloya ek erişimler gerekebilir.
Aynı index, yalnızca created_at üzerinde filtre uygulayan bir sorgu için aynı derecede yararlı değildir. Çünkü B-Tree sıralamasının ilk bileşeni customer_id değeridir. Bu özellik genellikle leftmost prefix ilkesiyle açıklanır. Bazı engine'ler belirli koşullarda skip scan gibi tekniklerle ilk kolon olmadan da index'ten yararlanabilir; yine de bu, index'in doğrudan tarih sırasına göre düzenlendiği anlamına gelmez.
Composite index tasarımındaki yaygın hata, sık kullanılan bütün kolonları tek bir index'e eklemektir. Daha fazla kolon, daha büyük key ve daha düşük page density anlamına gelebilir. Ayrıca index'in ilk kolonları sorguların filtreleme biçimiyle uyuşmuyorsa geniş index beklenen faydayı sağlamaz.
Covering index burada farklı bir çözüm sunar. Covering index, belirli bir sorgunun ihtiyaç duyduğu bütün kolonları temel tabloya ek erişim gerektirmeden sağlayabilen index'tir. Bu, index'in mutlak bir özelliği değil, index ile sorgu arasındaki ilişkidir.
Örneğin PostgreSQL'de şu yapı düşünülebilir:
CREATE INDEX idx_orders_customer_created_cover
ON orders (customer_id, created_at)
INCLUDE (total_amount);INCLUDE, total_amount kolonunu arama sırasını belirleyen key'e eklemeden leaf entry'lerde saklar. Ancak sorgu id kolonunu da istiyorsa onun da index tarafından sağlanması gerekir; PostgreSQL'de primary key kolonları secondary index'e otomatik olarak eklenmez. Yukarıdaki sorgunun gerçekten covering olması için id de eklenebilir veya sorgunun projection'ı değiştirilebilir.
PostgreSQL'de bütün kolonlar index içinde olsa bile Index Only Scan her zaman heap erişimini tamamen ortadan kaldırmaz. MVCC visibility bilgisinin doğrulanması gerekebilir. Visibility map ilgili heap page'in tüm tuple'larının görünür olduğunu belirtmiyorsa engine heap'e bakar. Bu, covering index'in neden bazı workload'larda beklenen kazancı vermediğini açıklayan önemli bir fiziksel ayrıntıdır.
Covering index ayrıca storage tüketir. Index entry'leri büyüdükçe aynı page'e daha az kayıt sığabilir. Daha fazla page, cache üzerinde daha fazla baskı ve bakım sırasında daha fazla veri hareketi anlamına gelir. Bir sorgunun lookup maliyetini azaltırken bütün sistemin write maliyetini artırmak mümkündür.
Bir sipariş sorgusunun execution plan'ı ne anlatır?
Bir backend engineer'ın sipariş geçmişi endpoint'ini yavaş bulduğunu düşünelim. PostgreSQL üzerinde çalışan orders tablosunda milyonlarca kayıt var. Endpoint belirli bir müşterinin en son 20 siparişini gösteriyor ve aşağıdaki sorguyu çalıştırıyor:
SELECT id, created_at, total_amount
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
Tabloda yalnızca primary key index bulunduğunu varsayalım. Optimizer, customer_id üzerinde uygun erişim yolu bulamadığında geniş bir Seq Scan ve ardından sıralama seçebilir. LIMIT 20 bulunması bütün işi otomatik olarak ucuzlatmaz; engine doğru 20 satırı belirleyebilmek için çok daha fazla kaydı incelemek zorunda kalabilir.
İlk ölçüm şu komutla yapılır:
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at, total_amount
FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
Burada EXPLAIN, optimizer'ın planını gösterir; ANALYZE sorguyu gerçekten çalıştırır ve gerçekleşen sürelerle satır sayılarını raporlar. BUFFERS ise shared buffer hit ve read gibi erişim bilgilerini gösterir. Bu bilgiler, problemin yalnızca CPU üzerinde mi yoksa page erişimlerinde mi yoğunlaştığını anlamaya yardımcı olur.
Sorguya uygun (customer_id, created_at) index'i eklendiğinde plan bir Index Scan içerebilir. Engine ilgili müşteri aralığına gidip ters yönde ilerleyebilir ve 20 kayıt bulduğunda durabilir. Bu durumda index'in faydası yalnızca arama hızından gelmez; çok sayıda satırı tarama ve ayrı sort yapma ihtiyacını azaltmasından gelir.
Şimdi aynı tabloda başka bir sorgu düşünelim:
SELECT id, customer_id, status, total_amount
FROM orders
WHERE status = 'completed';
completed kayıtları tablonun büyük bölümünü oluşturuyorsa status index'i bu sorguya yardımcı olmayabilir. Hatta optimizer index üzerinden gidip her sonuç için heap erişimi yaparsa sequential scan'den daha fazla I/O üretebilir. Burada doğru karar, index'i zorla kullandırmak değil, planın neden o erişim yolunu seçtiğini incelemektir.
Execution plan yorumlarken estimated rows ile actual rows arasındaki fark özellikle değerlidir. Tahmin birkaç yüz satırken gerçekleşen sonuç yüz binlerce satırsa maliyet modeli yanlış girdilerle çalışmış olabilir. Statistics güncellemek, sorguyu yeniden düzenlemek veya kolon correlation'ını daha iyi temsil eden statistics kullanmak index eklemekten daha etkili olabilir.
BUFFERS çıktısındaki yüksek hit sayısı da tek başına sorun kanıtı değildir; cache içindeki erişimler fiziksel disk okumalarından farklı maliyettedir. Benzer şekilde düşük execution time ile yüksek toplam sistem maliyeti aynı anda görülebilir. Tek sorgu hızlı çalışırken eşzamanlı transaction'lar index bakımından dolayı yavaşlayabilir.
Bu nedenle inceleme yalnızca tek bir EXPLAIN ANALYZE çıktısıyla bitmez. Sorgu farklı müşteri büyüklüklerinde denenmeli, gerçek parametre dağılımı dikkate alınmalı ve yoğun write sırasında etkisi ölçülmelidir. Özellikle prepared statement kullanan sistemlerde generic plan ile parametreye özel plan arasındaki fark da sonucu değiştirebilir.
Index eklemek değil, toplam workload maliyetini düşürmek hedeflenmeli
Her index, tabloya eklenen ayrı bir depolama ve bakım sorumluluğudur. INSERT sırasında yeni index entry'leri oluşturulur. DELETE işlemleri index kayıtlarının daha sonra temizlenmesini gerektirebilir. UPDATE ise değiştirilen kolonlara ve database engine'e bağlı olarak index entry'lerinin yeniden yazılmasına neden olabilir.
PostgreSQL'de HOT update, uygun koşullarda yeni index entry'leri oluşturmadan satır güncellenmesini sağlayabilir. Fakat index tarafından kullanılan bir kolonun değişmesi bu optimizasyonu engelleyebilir. Dolayısıyla sık güncellenen bir kolona index eklemek, daha önce ucuz gerçekleşen UPDATE işlemlerini pahalılaştırabilir.
B-Tree page dolduğunda page split gerekebilir. Bu işlem yeni page oluşturulmasına, entry'lerin yeniden dağıtılmasına ve ek write faaliyetlerine yol açabilir. WAL kullanan sistemlerde index değişiklikleri log trafiğini de artırır. Sonuç yalnızca daha yavaş INSERT değildir; daha büyük backup, daha fazla replication trafiği ve cache üzerinde ek baskı da oluşabilir.
Storage maliyeti de yalnızca index dosyasının disk üzerindeki boyutuyla sınırlı değildir. Büyük index'ler memory içinde daha az etkili cache kullanımı yaratabilir. Bir index'i eklemenin fırsat maliyeti, aynı memory alanında tutulabilecek başka veri ve index sayfalarının dışarı itilmesidir.
Bu yüzden önerim, her sık kullanılan WHERE kolonuna index açmak yerine belirli sorgu kalıpları için ölçülebilir erişim yolları tasarlamaktır. Önce yavaş sorgunun execution plan'ını inceleyin. Ardından filtreleme, sıralama ve dönen kolonları birlikte düşünerek mümkün olan en dar index'i oluşturun. Eklenen index'in read kazancını, write throughput ve storage maliyetiyle aynı workload altında karşılaştırın.
Bir index'in gerçekten gerekli olup olmadığını değerlendirirken onun başka bir index tarafından karşılanıp karşılanmadığına da bakılmalıdır. (customer_id, created_at) index'i bulunan bir tabloda ayrı bir (customer_id) index'i bazı sorgular için gereksiz olabilir. Ancak daha dar index'in daha küçük olması nedeniyle daha ucuz erişim sağlaması mümkündür; bu yüzden yalnızca prefix benzerliğine dayanarak silme kararı verilmemelidir.
Bu yaklaşımın sınırı, workload'ın henüz bilinmediği veya sürekli değiştiği sistemlerdir. Yeni bir ürün özelliği farklı sorgu kalıpları oluşturabilir; veri dağılımı zamanla değişebilir. Bugün iyi çalışan bir index, yarın düşük selectivity veya farklı projection nedeniyle etkisini kaybedebilir. Böyle durumlarda index tasarımı tek seferlik schema kararı değil, gözlemlenen sorgulara göre yeniden değerlendirilen bir bakım işidir.
Son karar basittir ama otomatik değildir: Index'i yalnızca daha hızlı bir arama vaat ettiği için eklemeyin. Sorgunun gerçekten hangi sayfaları okuyacağını, kaç satıra ulaşacağını ve değişikliklerin kaç ek yapıyı güncelleyeceğini hesaplayın. Bir index ancak bu toplam maliyeti düşürdüğünde performans optimizasyonudur.
yorumlar
0Henüz yorum yok. İlk notu sen bırak.
Yorum yazmak için giriş yap.
Gmail ile saniyeler içinde, ya da e-posta ile kaydol.